Google Search đang "lỗi thời", điều xảy ra tiếp theo còn tồi tệ hơn
Bạn có bao giờ nhận ra dạo này tra Google đôi khi gặp những câu trả lời ngớ ngẩn, thậm chí AI còn tự bịa ra thông tin? Ví dụ, có người chờ hoàng hôn xuống nhưng AI của Google lại tỉnh bơ bảo rằng... trời đã tối từ đời nào rồi. Khi AI đứng giữa người dùng và nguồn tin gốc, việc tìm kiếm thông tin trên Internet có thể trở nên khó khăn và dễ sai lệch hơn, The Walrus viết.
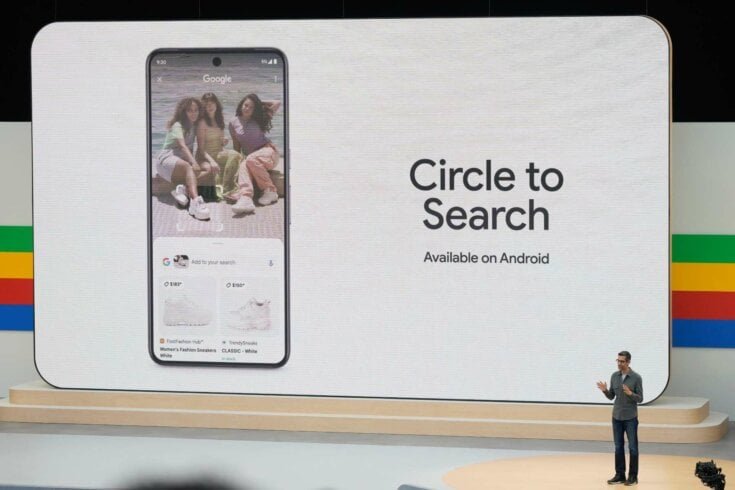
CEO của Alphabet, Sundar Pichai, phát biểu về Circle to Search tại sự kiện Google I/O. (Ảnh AP/Jeff Chiu) Ảnh
Google từng là nơi người dùng tìm câu trả lời cho gần như mọi câu hỏi trên Internet. Nhưng khi trí tuệ nhân tạo (AI) ngày càng can thiệp sâu vào công cụ tìm kiếm, khả năng tìm kiếm thông tin chính xác đang suy giảm, trong khi một vấn đề nghiêm trọng hơn xuất hiện: “bộ nhớ” của Internet có nguy cơ biến mất.
Một ví dụ tưởng nhỏ nhưng đáng lo là thông tin về thời điểm mặt trời lặn. Google gần đây đưa ra các bản tóm tắt bằng AI, nhưng đôi khi lại cung cấp thời gian sai. Những lỗi như vậy cho thấy công cụ tìm kiếm từng nổi tiếng với khả năng đưa người dùng đến thông tin chính xác đang gặp vấn đề ngay cả với những dữ liệu cơ bản.
Điều đáng ngại không chỉ nằm ở việc AI trả lời sai. Vấn đề lớn hơn là thông tin gốc ngày càng khó tìm, thậm chí biến mất hoàn toàn.
Internet vốn đã chịu tình trạng “link rot” – các liên kết và trang web cũ dần biến mất. Một số nội dung quan trọng từng bị xóa hoặc tạm thời biến mất chỉ vì lỗi kỹ thuật. Trong khi đó, việc Google đặt một lớp AI ở giữa người dùng và nguồn thông tin gốc khiến những trang vẫn tồn tại trên mạng có thể trở nên gần như không thể tiếp cận.
Tình trạng này còn trở nên phức tạp hơn khi chính Internet bắt đầu bị “nhiễm” nội dung do AI tạo ra. Một số công ty thậm chí bị cáo buộc đưa nội dung vào Reddit nhằm tác động đến câu trả lời của các công cụ tìm kiếm AI. Điều đó đồng nghĩa với việc AI không chỉ tổng hợp thông tin trên Internet mà còn có thể làm thay đổi chính nguồn dữ liệu mà nó sử dụng.
Một trường hợp đáng chú ý là FiveThirtyEight, trang web nổi tiếng về phân tích thăm dò, chính trị, kinh tế và thể thao. Sau khi chủ sở hữu không còn coi trang này là tài sản hoạt động hiệu quả, toàn bộ kho nội dung của FiveThirtyEight đã bị xóa vào năm 2025. Hàng loạt bài viết từng tồn tại trên Internet vì thế biến mất chỉ sau một quyết định của doanh nghiệp.
Ngay cả Wikipedia cũng đang đứng trước nghịch lý tương tự. Trong nhiều năm, Google và các công cụ tìm kiếm đưa hàng tỷ lượt người dùng đến Wikipedia. Nhưng hiện nay, các hệ thống AI có thể trực tiếp lấy và sử dụng nội dung Wikipedia để tạo câu trả lời, khiến người dùng không còn cần truy cập trang gốc. Lượng truy cập giảm đồng nghĩa với việc nguồn đóng góp và tài trợ cho Wikipedia cũng có nguy cơ suy giảm, đe dọa chính nền tảng tri thức mà AI đang khai thác.
Internet Archive, đặc biệt là công cụ Wayback Machine, cũng chịu áp lực lớn. Đây là một trong những “bộ nhớ dự phòng” quan trọng nhất của Internet, lưu giữ hàng trăm tỷ bản chụp các trang web qua nhiều thời điểm. Nhà báo, nhà nghiên cứu, luật sư và người dùng có thể dựa vào đó để khôi phục những trang đã bị xóa hoặc kiểm chứng thông tin trong quá khứ.
Tuy nhiên, Internet Archive đang phải đối mặt với chi phí lưu trữ khổng lồ, các cuộc tấn công mạng và những vụ kiện liên quan đến bản quyền. Một số hãng tin còn chặn trình thu thập dữ liệu của Wayback Machine vì lo ngại nội dung được lưu trữ có thể trở thành nguồn gián tiếp cho các công ty AI. Những hạn chế này khiến khả năng lưu giữ lịch sử Internet ngày càng bị thu hẹp.
Trong khi đó, nhiều nội dung trên mạng xã hội như Instagram Stories hay WhatsApp Status vốn được thiết kế để biến mất sau một thời gian. Điều này khiến một phần đáng kể đời sống văn hóa, xã hội và chính trị của con người không bao giờ được lưu trữ lâu dài.
Một số quốc gia đang tìm cách giảm sự phụ thuộc vào các tập đoàn công nghệ lớn. Pháp đã thúc đẩy sử dụng Qwant, công cụ tìm kiếm của châu Âu không lưu dữ liệu tìm kiếm để bán thông tin cá nhân hay quảng cáo theo dõi người dùng. Một số chính phủ châu Âu cũng chuyển sang các phần mềm và nền tảng mã nguồn mở nhằm giảm phụ thuộc vào các nhà cung cấp nước ngoài.
Đáng chú ý, một tòa án Đức gần đây còn phán quyết Google phải chịu trách nhiệm đối với những thông tin sai do tính năng AI Overview tạo ra. Lập luận của tòa án là khi Google tự trích xuất, viết lại và trình bày thông tin, công ty không còn đơn thuần đóng vai trò trung gian dẫn người dùng tới nguồn tin, mà đang tạo ra một lớp nội dung mới và phải chịu trách nhiệm về nó.
Theo The Walrus, các chính phủ cần coi việc bảo tồn và tiếp cận thông tin số là một phần của hạ tầng công cộng, thay vì để nó hoàn toàn phụ thuộc vào các công ty tư nhân. Thông tin có giá trị kinh tế, đồng thời dữ liệu từ những truy vấn tưởng như vô hại cũng có thể tiết lộ những đặc điểm nhạy cảm về xã hội và người dân.
Cuối cùng, The Walrus cảnh báo thỏa thuận cũ giữa con người và Google - “trao sự tò mò và nhận lại cả thế giới” - đang dần kết thúc. Tương lai có thể là một Internet được máy móc ghi nhớ một cách ngẫu nhiên, rồi bị các bên trung gian khai thác để kiếm tiền. Nhưng cũng có một khả năng khác: xây dựng một Internet công cộng, nơi lịch sử và tri thức được bảo tồn không phải vì chúng có lợi nhuận, mà vì đó là ký ức chung của chúng ta.
Theo danviet.vn
https://danviet.vn/google-search-dang-loi-thoi-dieu-xay-ra-tiep-theo-con-toi-te-hon-d1450782.html
- Bảng giá iPhone 18 series, mẫu cao nhất 104 triệu đồng: Bao giờ mở bán ở Việt Nam? 10.09.2026 | 15:48 PM
- Apple ra mắt loạt sản phẩm mới, iPhone gập đầu tiên lên kệ từ ngày 23/10 10.09.2026 | 09:26 AM
- Người dùng, chuyên gia nói gì về iPhone 18 series vừa ra mắt? 10.09.2026 | 15:54 PM
- Đà Nẵng mở không gian tầm thấp: Từ thí điểm dịch vụ đến hạ tầng kinh tế mới 09.09.2026 | 16:17 PM
- Bước tiến của hệ sinh thái khởi nghiệp sáng tạo 09.09.2026 | 18:25 PM
- Giới tỷ phú công nghệ bất ngờ ồ ạt "bơm tiền" sang "vùng đất hứa" mới ít ai ngờ tới 09.09.2026 | 18:33 PM
- Google thử nghiệm tính năng điều khiển bằng giọng nói trên bộ công cụ Workspace 08.09.2026 | 10:10 AM
- Để sáng chế y dược không dừng lại trong phòng thí nghiệm 07.09.2026 | 17:12 PM
- Hé lộ công nghệ đặc biệt giúp con người du hành không gian "dễ như đi chợ" 07.09.2026 | 17:22 PM
- Vì sao Suzuki Fronx giảm giá “sập sàn” tháng 9/2026, rẻ hơn Hyundai Grand i10? 07.09.2026 | 17:22 PM
 Trời đẹp
27oC 30oC
27oC 30oC
27oC 30oC



Thưa quý vị và các bạn Trong chuyên mục tuần này chúng tôi xin được giải đáp những vướng mắc về pháp luật qua đơn thư chúng tôi đã tổng hợp được trong tuần qua như sau:
-
Trả lời bạn xem truyền hình ngày 22/04/2025
Thưa quý vị và các bạn Trong chuyên mục tuần này chúng tôi xin được giải...
-
Trả lời bạn xem truyền hình ngày 15/04/2025
Thưa quý vị và các bạn, trong chuyên mục tuần này chúng tôi xin được giải...
-
Trả lời bạn xem truyền hình ngày 08/04/2025
Thưa quý vị và các bạn, trong chuyên mục tuần này chúng tôi xin được giải...